AI Streamer
AI配信者
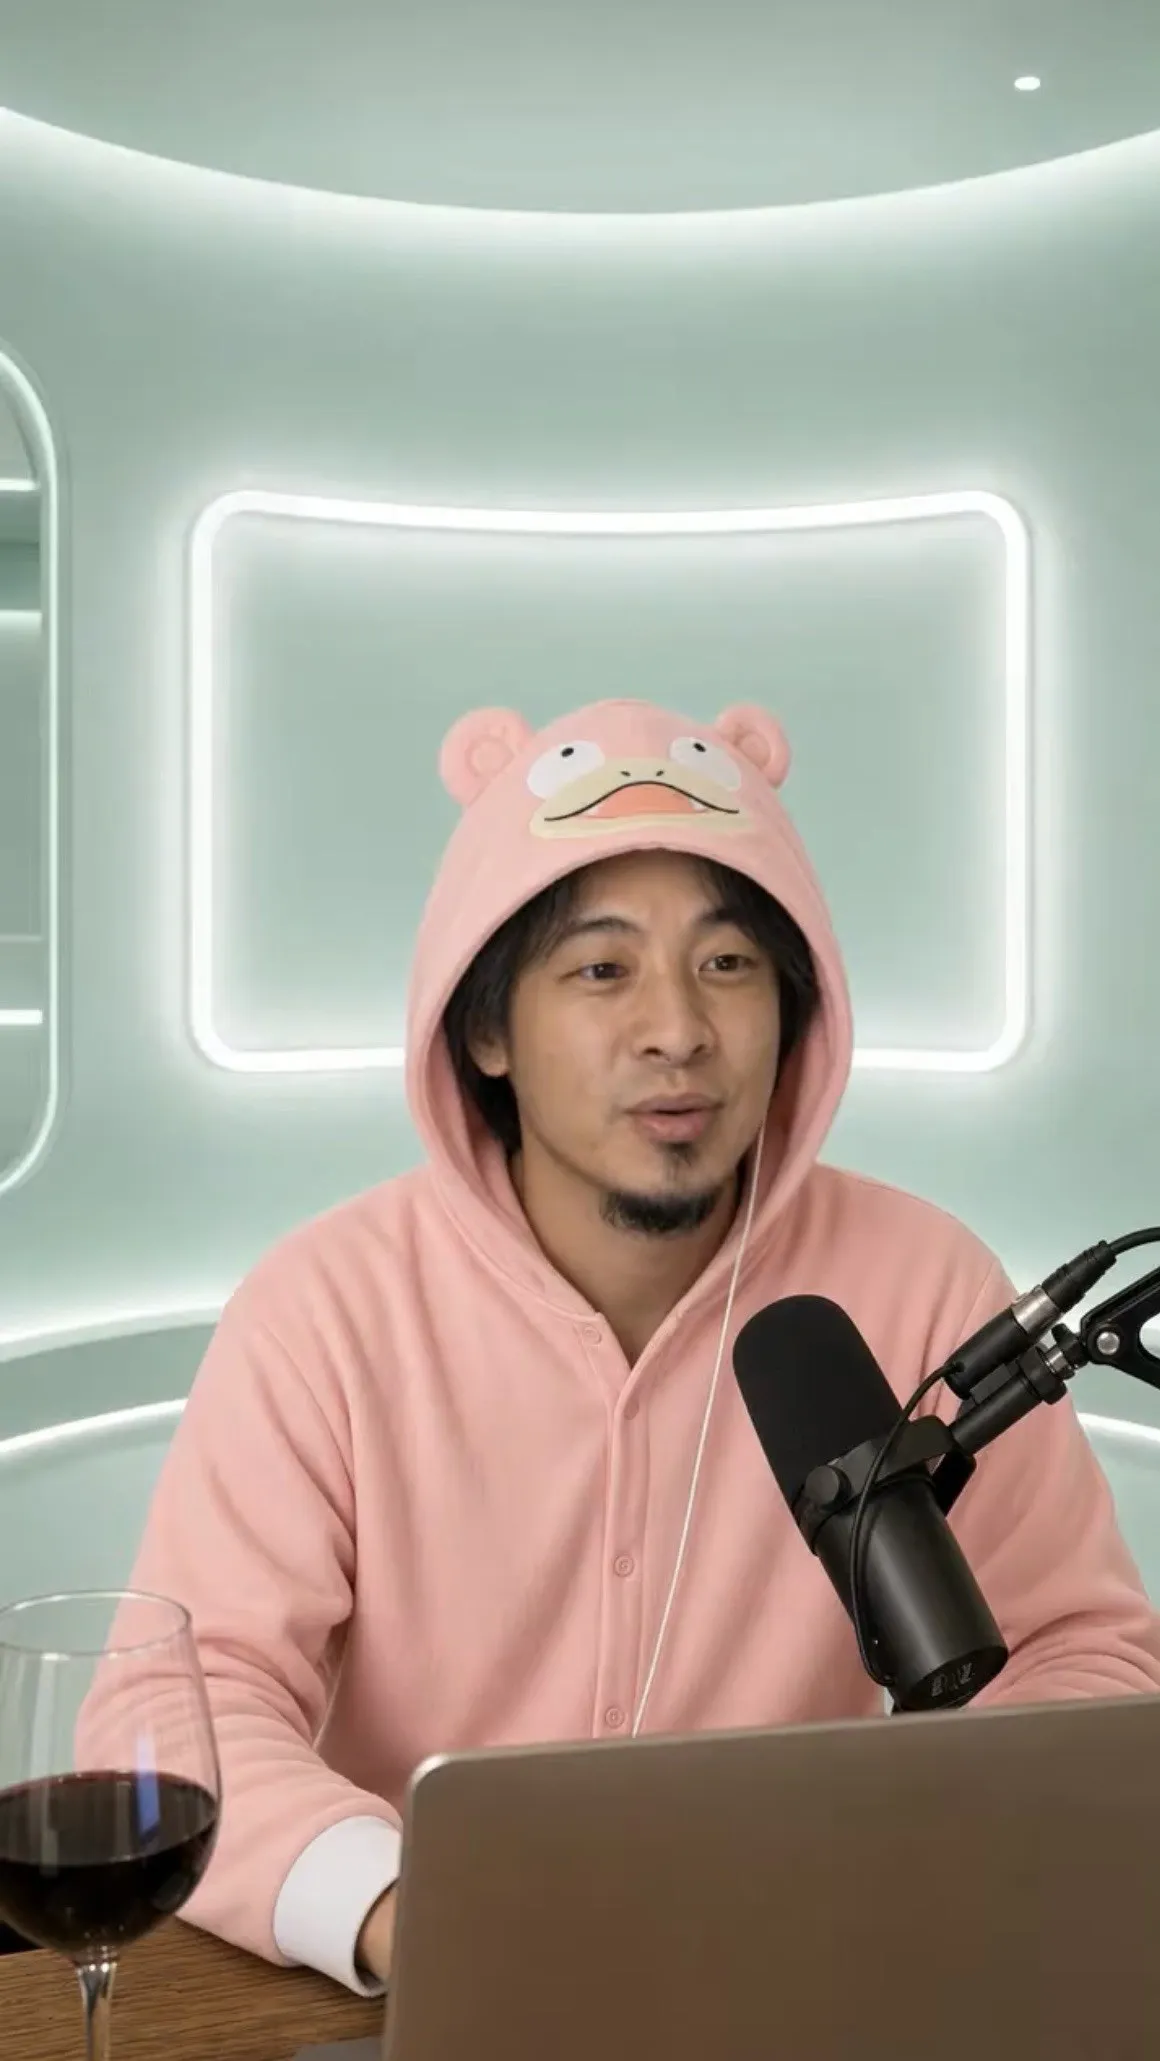
実在の人物のAI版が、本人の顔と声と口調で、自分から話題をつくって話し続けるライブ配信。
LIVE2026.10.18
- 記録本人の配信字幕とコメントから、間と長さと脱線を測る
- 話の流れコード測った分布から引いて、流れを決める
- 文LLM決まった流れに沿って、文を書く
- 判断Jevはいか、いいえだけを決める
- 声Irodori-TTS実際の音声を聞き比べて選ぶ
- 顔AVTR-1まばたきと目線は自作の層
- 配信YouTubeAWSで動かし、一つの命令で起動
つくったもの
ひろゆき氏本人の許諾を得て作った、氏の顔と声と口調のAIが、2026年10月18日にYouTubeで配信しました。コメントがなくても自分から話し、途中で落ちず、声と顔の遅れも出ませんでした。配信ではAIであることを示しています。
その前には研究室の教授に許可をもらった顔で長時間の自律配信を行い、研究室で好評でした。
記録から測った話し方
人格は「こういう性格で」と指示しても立ちませんでした。そこで、ひろゆき氏の過去の配信の字幕とコメントから、間の取り方、話の長さ、話がそれる割合、答え方の形を測りました。AIはその分布から引いて話します。
出来はLLMに採点させず、どの作り方かを伏せて聞き比べ、耳で決めます。
役割ごとに道具を分ける
LLMに話の組み立てまで任せると、脇道へそれ続けました。そこで、話の流れはコード、文はLLM、はいかいいえの判断はJev、知識は検索(RAG)に分けました。人物ごとの値もコードから分けてあり、素材を置けば別の人物のAIも同じ手順で動きます。
声はIrodori-TTS、顔はAVTR-1で、まばたきや目線は自作の層で重ねています。声と顔のモデルは実際の音声と映像で比べて選びました。
配信は研究室のAWSで動かし、起動から配信までを一つの命令で進めます。消し忘れを防ぐ自動停止も付けています。
これから
6人のチームで、研究と事業化を進めています。私はひろゆき氏のAIの改善と研究を受け持ち、ほかのメンバーが別の人物のAI、配信の企画、インフラ、SNSを受け持ちます。AI配信者は私の修士研究の土台でもあります。